Gdy kamera, laptop albo maszyna musi zareagować natychmiast, wysyłanie każdej informacji do odległego centrum danych może być zwyczajnie zbyt wolne. Właśnie dlatego przetwarzanie brzegowe przenosi analizę bliżej urządzenia, ogranicza przesyłanie danych i pozwala działać nawet przy niestabilnym połączeniu z internetem. Pokażę, jak działa ten model, czym różni się od chmury, gdzie sprawdza się najlepiej i jak podejść do niego rozsądnie w świecie komputerów, laptopów oraz urządzeń IoT.
Najważniejsza zasada brzmi prosto: decyzje podejmuj blisko danych, a cięższe analizy zostaw chmurze
- Edge computing przetwarza dane przy ich źródle, na przykład w laptopie, kamerze, routerze lub lokalnym serwerze.
- Mniejsze opóźnienia ułatwiają reakcję w czasie rzeczywistym, między innymi podczas analizy obrazu i sterowania maszynami.
- Chmura i infrastruktura edge zwykle się uzupełniają, zamiast wzajemnie zastępować.
- Lokalna analiza ogranicza transfer danych, ale nie gwarantuje automatycznie większego bezpieczeństwa.
- Udane wdrożenie wymaga monitorowania urządzeń, aktualizacji oprogramowania i planu działania bez internetu.
Co naprawdę oznacza praca na brzegu sieci
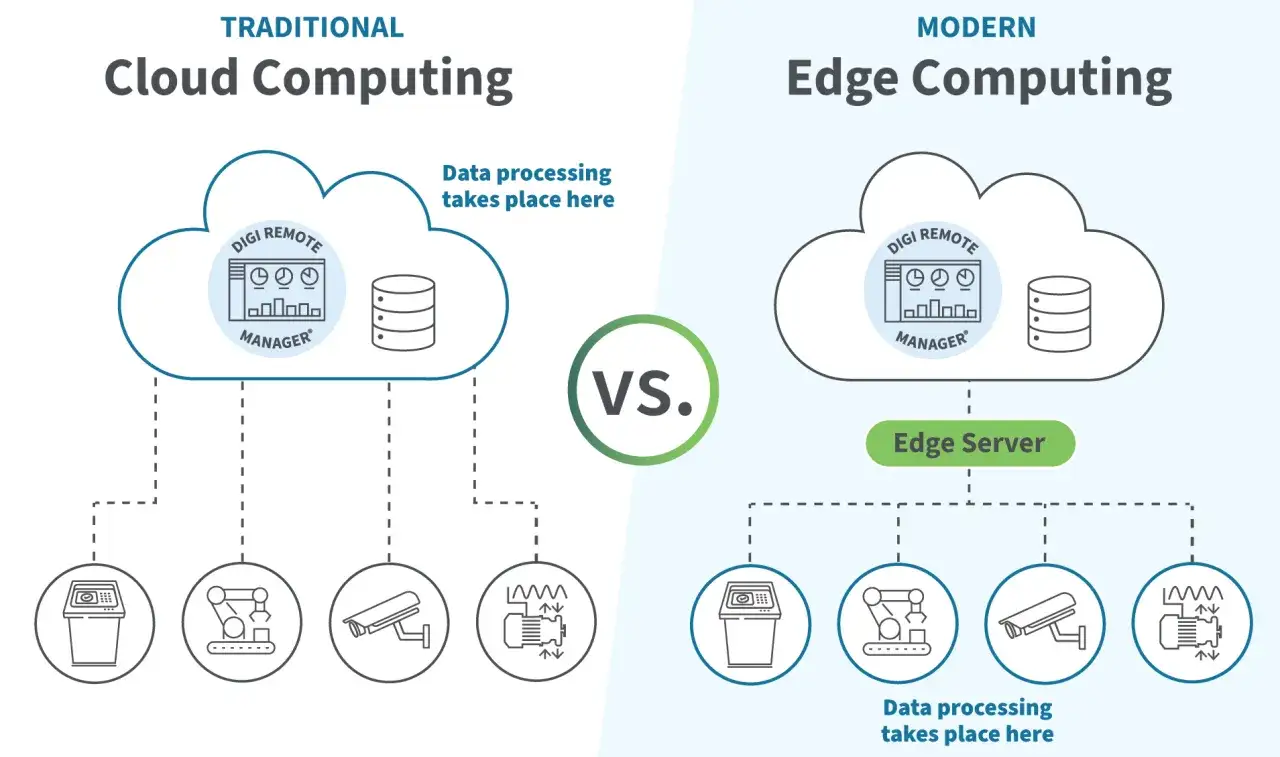
W klasycznym modelu urządzenie zbiera dane i wysyła je do centralnego serwera albo chmury. Tam odbywa się analiza, a wynik wraca do użytkownika. W modelu edge część obliczeń wykonuje się tam, gdzie powstają dane, czyli bliżej kamery, czujnika, laptopa czy maszyny.
Takim węzłem brzegowym może być zarówno niewielki komputer przemysłowy, jak i zwykły laptop z układem NPU. NPU to wyspecjalizowany procesor do zadań sztucznej inteligencji, na przykład rozpoznawania mowy lub obrazu. W praktyce laptop może analizować nagranie lokalnie, a do chmury wysyłać wyłącznie gotowy wynik.
Trzy miejsca, w których mogą odbywać się obliczenia
- Na urządzeniu końcowym, takim jak laptop, smartfon, kamera lub robot.
- W lokalnej bramie, która zbiera dane z wielu urządzeń i filtruje je przed wysłaniem dalej.
- W pobliskim centrum danych, które zapewnia większą moc, ale nadal znajduje się znacznie bliżej użytkownika niż odległa chmura.
Najczęściej nie wybiera się tylko jednego poziomu. Kamera może wykonać wstępne rozpoznanie lokalnie, serwer w zakładzie połączyć wyniki z danymi produkcyjnymi, a chmura przeanalizować statystyki z kilku miesięcy. Taki podział jest rozsądniejszy niż próba uruchamiania całego systemu wyłącznie na laptopie albo wyłącznie w centrum danych.
| Model | Gdzie odbywa się analiza | Największa zaleta | Typowe ograniczenie |
|---|---|---|---|
| Urządzenie końcowe | Laptop, kamera lub czujnik | Najkrótszy czas reakcji | Ograniczona moc i pamięć |
| Węzeł lokalny | Router, brama lub serwer w firmie | Obsługa wielu urządzeń | Konieczność utrzymania sprzętu |
| Chmura | Zewnętrzne centrum danych | Duża skalowalność | Zależność od sieci i opóźnień |
Nie utożsamiam tego rozwiązania z całkowitym odejściem od chmury. Trafniejsze jest określenie rozproszonego przetwarzania, w którym każda część infrastruktury wykonuje zadania najlepiej dopasowane do swoich możliwości.
Dlaczego dane warto czasem analizować lokalnie
Najbardziej oczywistą korzyścią jest czas reakcji. Jeżeli informacja nie musi pokonać drogi do zewnętrznego serwera i wrócić, system może zadziałać szybciej. W europejskich założeniach dotyczących węzłów brzegowych często pojawia się poziom opóźnienia poniżej 20 milisekund, choć rzeczywisty wynik zależy od sprzętu, sieci i aplikacji.
Ma to znaczenie przy sterowaniu robotem, wykrywaniu przeszkody przez pojazd albo analizie obrazu z kamery. W edytorze tekstu czy zwykłej poczcie elektronicznej dodatkowe 100 milisekund zwykle nikogo nie obchodzi. W systemie przemysłowym albo podczas rozmowy głosowej prowadzonej przez lokalny model AI różnica może być już wyraźna.
Mniej danych przesyłanych przez sieć
Jedna kamera Full HD może generować orientacyjnie kilka megabitów danych na sekundę, zależnie od kodeka, liczby klatek i jakości obrazu. Przy 50 kamerach ciągłe przesyłanie pełnych nagrań oznacza już setki megabitów na sekundę, a do tego dochodzą koszty przechowywania i analizy.
Lokalny komputer może odrzucać nieistotne fragmenty, a do chmury wysyłać tylko zdarzenia, metadane lub krótkie klipy. Zmniejsza to obciążenie łącza, ale nie zawsze oznacza niższy koszt całkowity. Trzeba doliczyć zakup urządzeń, ich serwis, zabezpieczenia i energię.
Działanie przy słabym połączeniu
System edge może nadal rozpoznawać obiekty, zapisywać pomiary i wykonywać podstawowe reguły, gdy internet przestanie działać. Dane można później zsynchronizować z serwerem. To ważne w magazynach, pojazdach, gospodarstwach rolnych i oddziałach firm znajdujących się poza dużymi miastami.
Nie oznacza to jednak pełnej niezależności. Jeśli aplikacja wymaga centralnej bazy, zewnętrznego modelu albo autoryzacji online, część funkcji może zostać wyłączona. Dlatego projektuję takie systemy z jasno określonym trybem awaryjnym offline, zamiast zakładać, że lokalne urządzenie rozwiąże każdy problem.
Większa kontrola nad wrażliwymi informacjami
Dokumenty, nagrania głosu i obrazy z monitoringu nie muszą opuszczać firmy, jeżeli analiza odbywa się lokalnie. To może ułatwić spełnienie wymagań dotyczących prywatności, ale sama lokalizacja danych nie jest zabezpieczeniem.
Rozproszona infrastruktura zwiększa liczbę urządzeń, które trzeba chronić. Potrzebne są między innymi szyfrowanie, silne uwierzytelnianie, bezpieczne aktualizacje i kontrola dostępu. Skradzione urządzenie edge może stać się tak samo niebezpieczne jak przejęte konto w chmurze.
Gdzie edge computing działa najlepiej
Największy sens ma tam, gdzie liczy się szybka reakcja, duża liczba danych albo ograniczony dostęp do internetu. Sama moda na lokalną analizę nie jest wystarczającym powodem do wdrożenia. Liczy się konkretny problem, którego nie da się wygodnie rozwiązać przez zwykłe przesłanie danych do serwera.
Laptopy i lokalna sztuczna inteligencja
Nowoczesny laptop może wykonywać lokalnie transkrypcję rozmów, redukcję szumu, tłumaczenie, generowanie podpowiedzi tekstowych czy analizę obrazu z kamery. Najważniejszą zaletą jest prywatność i szybka odpowiedź, szczególnie gdy użytkownik pracuje bez stabilnego internetu.
Trzeba jednak pamiętać o kompromisie. Mały model AI działający na laptopie może być szybki i oszczędny, ale zwykle nie dorówna możliwościami dużemu modelowi uruchomionemu w centrum danych. Z mojego punktu widzenia najlepszy jest układ hybrydowy: proste i wrażliwe zadania lokalnie, cięższe obliczenia w chmurze.
Monitoring i analiza obrazu
Kamera połączona z lokalnym komputerem może wykrywać wejście do strefy zamkniętej, brak kasku, pozostawiony przedmiot albo nietypowy ruch. Do operatora trafia wtedy powiadomienie, a nie wielogodzinny strumień nagrania wymagający ręcznego przeglądania.
To dobry przykład zastosowania, w którym edge ogranicza transfer i przyspiesza reakcję. Nie rozwiązuje jednak problemu błędnych rozpoznań. Model trzeba testować w różnych warunkach oświetleniowych, a decyzje dotyczące bezpieczeństwa powinny uwzględniać udział człowieka, szczególnie gdy pomyłka może mieć poważne skutki.
Fabryki i magazyny
Czujniki mogą mierzyć temperaturę, drgania, ciśnienie i pobór energii. Lokalny system analizuje te dane w czasie rzeczywistym, wykrywa odchylenia i przekazuje do systemu zarządzającego tylko najważniejsze informacje.
W fabryce edge może zatrzymać linię, gdy wykryje niebezpieczny stan, albo przewidzieć awarię urządzenia na podstawie nietypowych drgań. Istotne są tu protokoły takie jak MQTT i OPC UA. Pierwszy służy do lekkiej wymiany komunikatów między urządzeniami, drugi pomaga łączyć urządzenia przemysłowe z oprogramowaniem IT.
Transport, handel i usługi publiczne
W pojazdach lokalne komputery analizują obraz z kamer, położenie i dane z czujników, ponieważ decyzja nie może czekać na odpowiedź z odległej serwerowni. W sklepie podobna infrastruktura może zliczać osoby, wykrywać puste półki albo wspierać kontrolę zapasów.
W miastach rozwiązania brzegowe pomagają analizować ruch drogowy i sterować sygnalizacją. W tym przypadku szczególnie ważne są ciągłość działania i ograniczenie transferu, bo przesyłanie wszystkich nagrań z miejskich kamer byłoby kosztowne i trudne do zarządzania.
Edge computing a chmura i zwykły laptop
Najczęstszy błąd polega na traktowaniu edge i chmury jak konkurencyjnych rozwiązań. W rzeczywistości chmura świetnie nadaje się do trenowania modeli, tworzenia raportów i przechowywania dużych zbiorów danych, natomiast urządzenie lokalne lepiej radzi sobie z decyzjami wymagającymi krótkiego czasu reakcji.
| Kryterium | Obliczenia lokalne | Chmura |
|---|---|---|
| Opóźnienie | Zwykle niższe | Zależne od łącza i odległości |
| Internet | Może działać częściowo offline | Zwykle potrzebuje stałego połączenia |
| Moc obliczeniowa | Ograniczona sprzętem na miejscu | Łatwo ją skalować |
| Prywatność | Dane mogą pozostać lokalnie | Dane są przesyłane do dostawcy |
| Utrzymanie | Firma odpowiada za urządzenia | Część infrastruktury obsługuje dostawca |
Zwykły laptop może być wystarczający, gdy analizujemy dane jednego użytkownika, na przykład dźwięk z mikrofonu albo obraz z kamery. Przy dziesiątkach urządzeń potrzebny jest już centralny węzeł lokalny, najlepiej z zapasowym zasilaniem i automatycznym nadzorem.
Nie kupowałbym mocniejszego sprzętu tylko dlatego, że ma działać „na brzegu”. Najpierw sprawdzam, czy problemem jest faktycznie opóźnienie, transfer, prywatność czy brak internetu. Dopiero potem dobieram procesor, pamięć RAM, akcelerator AI i sposób przechowywania danych.
Jak zaplanować wdrożenie i nie przepłacić
Rozsądne wdrożenie zaczyna się od jednego scenariusza, a nie od zakupu całej floty urządzeń. Najlepiej wybrać proces, w którym można zmierzyć czas reakcji, liczbę przesyłanych danych i liczbę błędów przed oraz po zmianie.
- Opisz decyzję, którą ma podejmować system. Nie „analizuj dane”, tylko na przykład „wykryj przegrzanie w ciągu sekundy”.
- Zmierz dane wejściowe. Sprawdź ich rozmiar, częstotliwość, format i to, jak długo muszą być przechowywane.
- Wybierz miejsce obliczeń. Proste zadania zostaw urządzeniu, a wymagające wielu źródeł danych przenieś na lokalny serwer.
- Ustal tryb awaryjny. Zdefiniuj, co dzieje się przy utracie internetu, zasilania albo połączenia z bazą danych.
- Zabezpiecz urządzenia. Użyj szyfrowania, segmentacji sieci, certyfikatów i kontroli aktualizacji.
- Monitoruj działanie. Zbieraj informacje o temperaturze, obciążeniu procesora, opóźnieniach, błędach i stanie dysku.
W kosztorysie trzeba uwzględnić nie tylko sprzęt. Regularnie pojawiają się wydatki na integrację, serwis, wymianę urządzeń, licencje i obsługę bezpieczeństwa. Tani komputer bez zdalnej administracji może po kilku miesiącach kosztować więcej niż droższy, ale łatwiejszy do utrzymania węzeł przemysłowy.
Przeczytaj również: Co spowalnia komputer? Prosta diagnoza krok po kroku
Najczęstsze pułapki
- Brak aktualizacji sprawia, że rozproszone urządzenia stają się łatwym celem ataku.
- Brak testów offline ujawnia problemy dopiero podczas awarii internetu.
- Zbyt ciężki model AI powoduje przegrzewanie, opóźnienia i szybkie zużycie baterii w laptopie.
- Nieprzemyślany zapis danych może zapełnić dysk lokalny w ciągu kilku dni.
- Brak kontroli wersji utrudnia sprawdzenie, który model lub program wygenerował konkretną decyzję.
Przy większej liczbie urządzeń przydają się kontenery, czyli odizolowane pakiety aplikacji z ich zależnościami. Ułatwiają wdrażanie tej samej wersji programu na wielu komputerach. Nie zastępują jednak monitoringu i polityki bezpieczeństwa, dlatego powinny być częścią większego planu, a nie jedynym pomysłem na zarządzanie.
Najlepszy model to rozsądny podział zadań
Edge computing ma sens wtedy, gdy lokalne obliczenia rozwiązują konkretny problem: skracają reakcję, ograniczają transfer, chronią dane albo zapewniają działanie bez internetu. Nie każda aplikacja potrzebuje takiej architektury, a przeniesienie obliczeń bliżej użytkownika zawsze oznacza dodatkowe urządzenia i obowiązki administracyjne.
Najbardziej praktyczne podejście łączy laptop lub inne urządzenie końcowe z lokalnym węzłem i chmurą. Lokalnie podejmuj szybkie decyzje, na serwerze zbieraj dane z wielu źródeł, a w chmurze trenuj modele i analizuj długoterminowe trendy. Taki podział daje zwykle najlepszy kompromis między szybkością, kosztami, prywatnością i wygodą zarządzania.